確率変数とは?サイコロの具体例で直感理解!離散・連続の違いと公式解説
統計学やデータサイエンス、高校数学の授業で多くの人が最初に突き当たる壁が「確率変数」という概念です。「変数」という言葉がついているものの、中学や高校の数学で学んだ方程式の $x$ や $y$ とは何が違うのか、なぜ大文字の $X$ と小文字の $x$ を厳密に書き分ける必要があるのか、腑に落ちないまま数式だけを暗記して挫折してしまうケースは珍しくありません。
確率変数の本質は極めてシンプルであり、「試行の結果に応じて値が変化し、それぞれの値に対応する確率があらかじめ決まっている変数」を指します。サイコロの出目やコインの表裏といった身近な具体例から、離散型と連続型の決定的な違い、期待値・分散、そして標準化まで、数学が苦手な方でも直感的にイメージできるよう整理して解説します。
📌 【この記事の重要ポイントまとめ】
- 要点1:確率変数は「何が起こるかによって値が決まる特別な変数」であり、サイコロを振る前の“ルールが詰まった箱”のような存在である。
- 要点2:サイコロの目のように数えられる「離散型」と、身長・気温のように途切れのない「連続型」では、確率の求め方(確率密度関数・面積計算)が根本から異なる。
- 要点3:大文字 $X$(確率変数)と小文字 $x$(実現値)を区別し、線形結合や標準化の仕組みを押さえることが統計検定や実務データ分析の最短ルートになる。
【直感理解】確率変数とは何か?サイコロとコインの具体例で徹底解説
統計学を学び始めた方が最も混乱しやすい「確率変数(Random Variable)」について、まずは日常的なアクションから紐解いていきます。
日常会話で「サイコロを振って出る目」を考えるとき、振る前は 1 から 6 のどの数字が出るか確定していません。しかし、「1 が出る確率は $\frac{1}{6}$」「2 が出る確率は $\frac{1}{6}$」というように、各数値が出る確率のルールは完全に決まっています。このように、「どの値をとるかが偶然によって決まり、それぞれの値をとる確率が定まっている変数」を確率変数と呼び、通常アルファベットの大文字の $X$ や $Y$ で表記します。
より分かりやすくするために、身近な2つの具体例を見てみましょう。
【具体例1:公正なサイコロを1回振る場合】
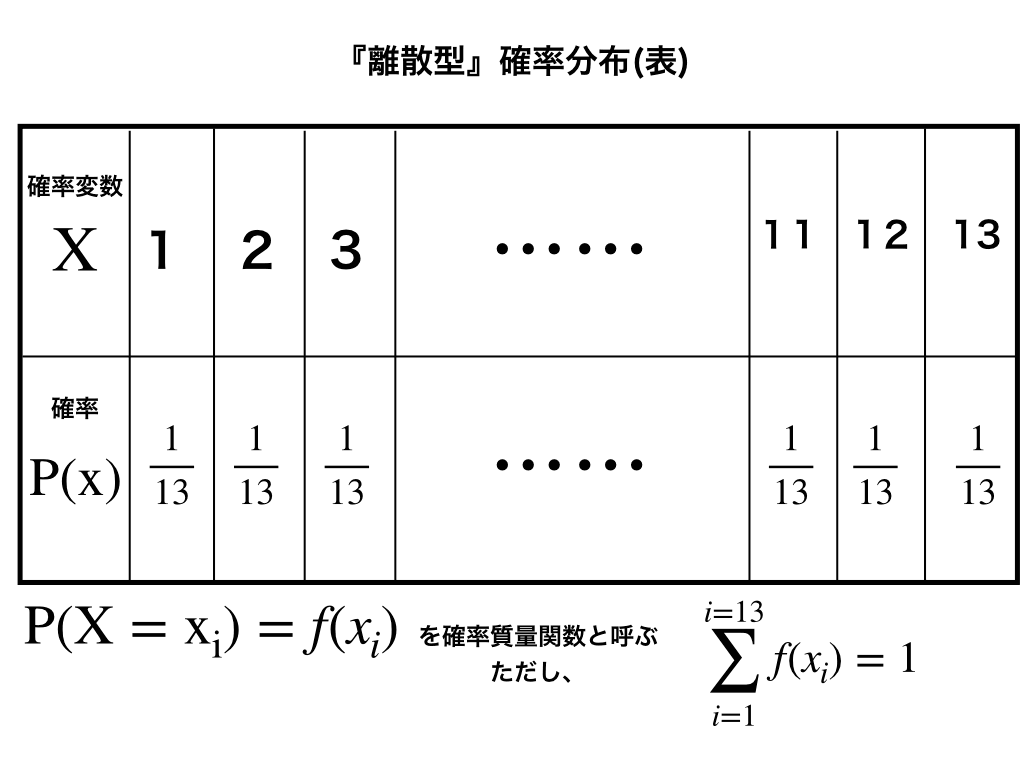
サイコロの出目を確率変数 $X$ と置くと、$X$ が取り得る値は $\{1, 2, 3, 4, 5, 6\}$ です。それぞれの値をとる確率はすべて等しく $\frac{1}{6}$ となります。数式で表すと以下の通りです。
$$P(X = 1) = \frac{1}{6}, \quad P(X = 2) = \frac{1}{6}, \quad \dots, \quad P(X = 6) = \frac{1}{6}$$
【具体例2:コイントスで得られるポイント】
表が出たら 100 円、裏が出たら 0 円もらえるゲームを考えます。獲得できる金額を確率変数 $X$ とすると、$X$ の取り得る値は 100 と 0 です。
$$P(X = 100) = 0.5, \quad P(X = 0) = 0.5$$
このように、確率変数は単なる「未知の数字」ではなく、「現象(事象)を数値に変換し、確率とセットで扱うための変換装置」と捉えると理解が一気に深まります。
【決定的な違い】確率変数と「実現値」の混同が挫折の引き金に
高校数学の「数学B・C」や大学の統計学入門、統計検定の対策で多くの学習者がつまずく最大の要因が、「確率変数」と「実現値」の混同です。
テキストを開くと、「$P(X = x)$」という謎めいた数式が頻繁に登場します。「大文字の $X$ と小文字の $x$ は何が違うのか?」という疑問こそが、数学アレルギーを引き起こす正体です。
両者の役割を明確に分けると、以下の関係になります。
・確率変数 $X$(大文字):サイコロを振る「前」の枠組み・状態そのもの
未来の可能性をすべて内包しており、「どんな値が出るか分からないが、確率の分布は決まっている」という概念的な器です。
・実現値 $x$(小文字):サイコロを振った「後」に実際に出た確定した具体的な数値
サイコロを振って実際に「4」が出た場合、この「4」が実現値 $x$ です。
つまり、$P(X = x)$ という表記は、「確率変数 $X$(これから振るサイコロ)が、具体的な値 $x$(例えば 4)という結果を出す確率」を意味しています。この違いを明確に意識できるようになると、確率統計の専門書に並ぶ数式が一気に読み解きやすくなります。
【徹底比較】離散型確率変数と連続型確率変数の決定的な違い
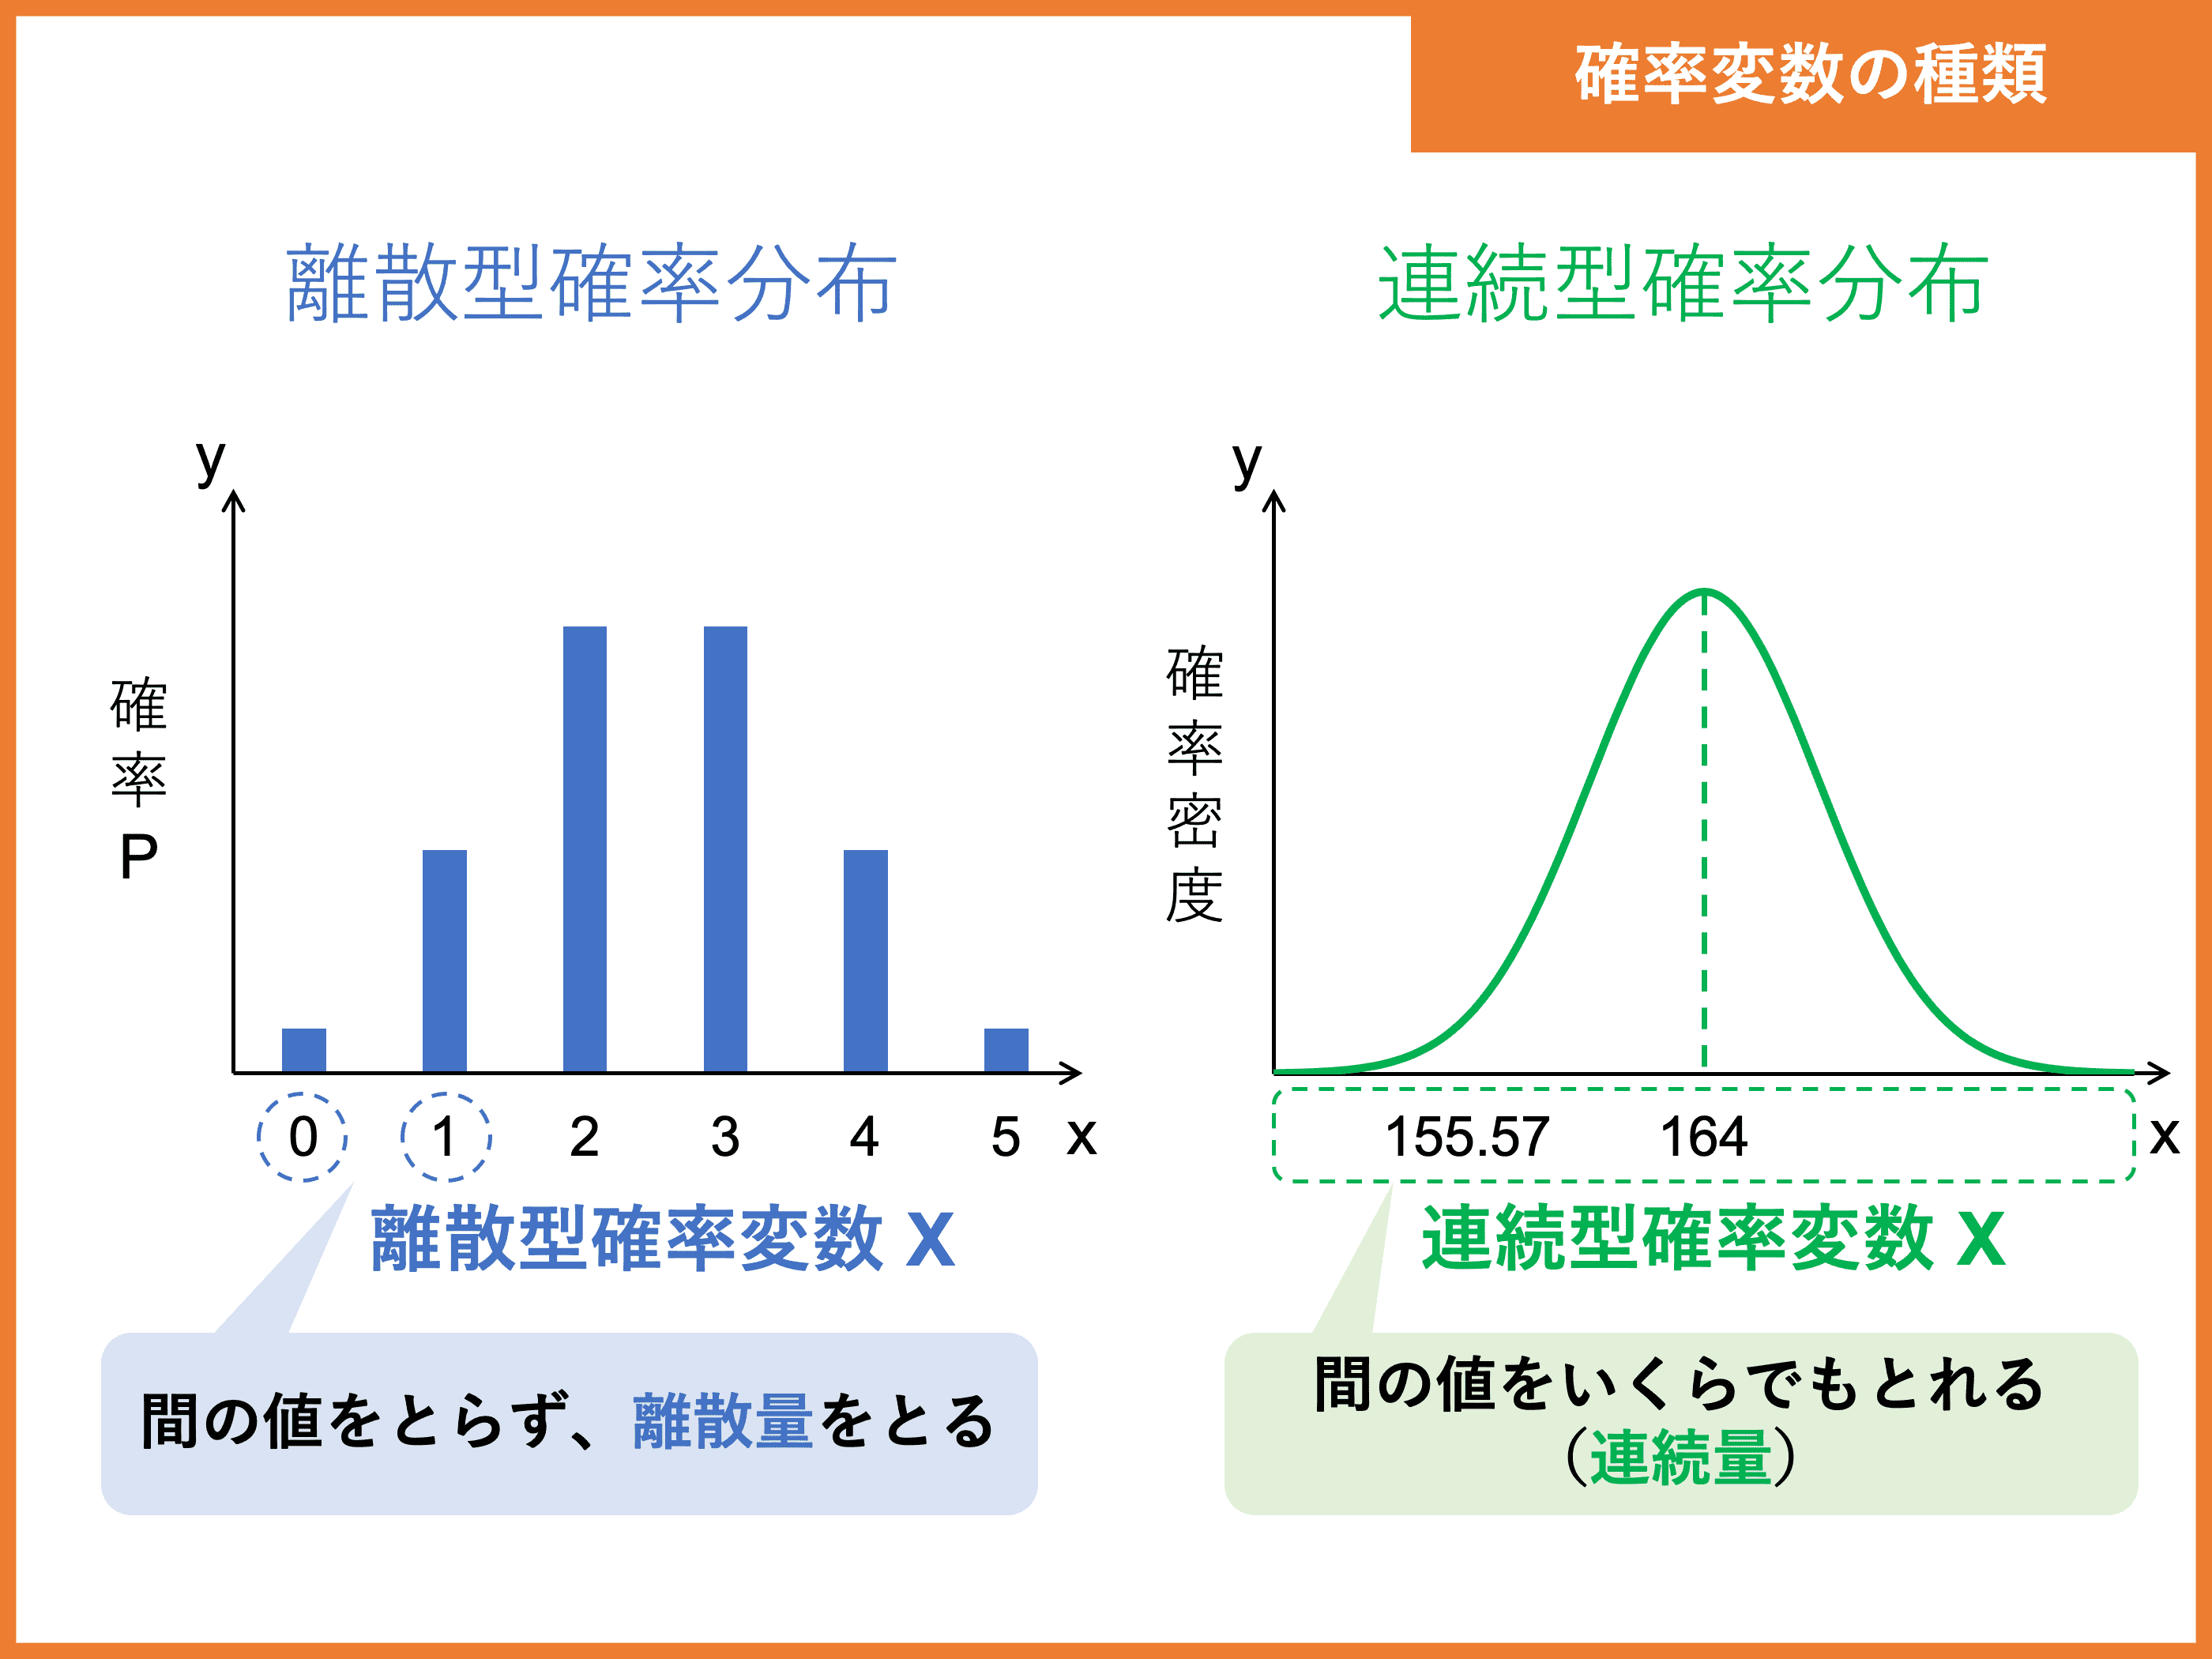
確率変数は、その値の性質によって「離散型(りさんがた)」と「連続型(れんぞくがた)」の2種類に大別されます。この分類を曖昧にしたまま学習を進めると、後に出てくる積分計算や確率密度関数の意味が分からなくなります。
両者の性質の違いを構造的に比較したデータが下表です。
| 区分 | 離散型確率変数(Discrete) | 連続型確率変数(Continuous) |
|---|---|---|
| 値の性質 | 1個, 2個, 3回のように飛び飛びで数えられる値 | 身長、体重、気温、時間のように連続する途切れのない値 |
| 具体例 | サイコロの目、Webサイトのクリック数、不良品数 | 成人男性の身長(cm)、サーバーの応答時間(秒) |
| 対応する関数 | 確率質量関数 $P(X = x)$ | 確率密度関数 $f(x)$ |
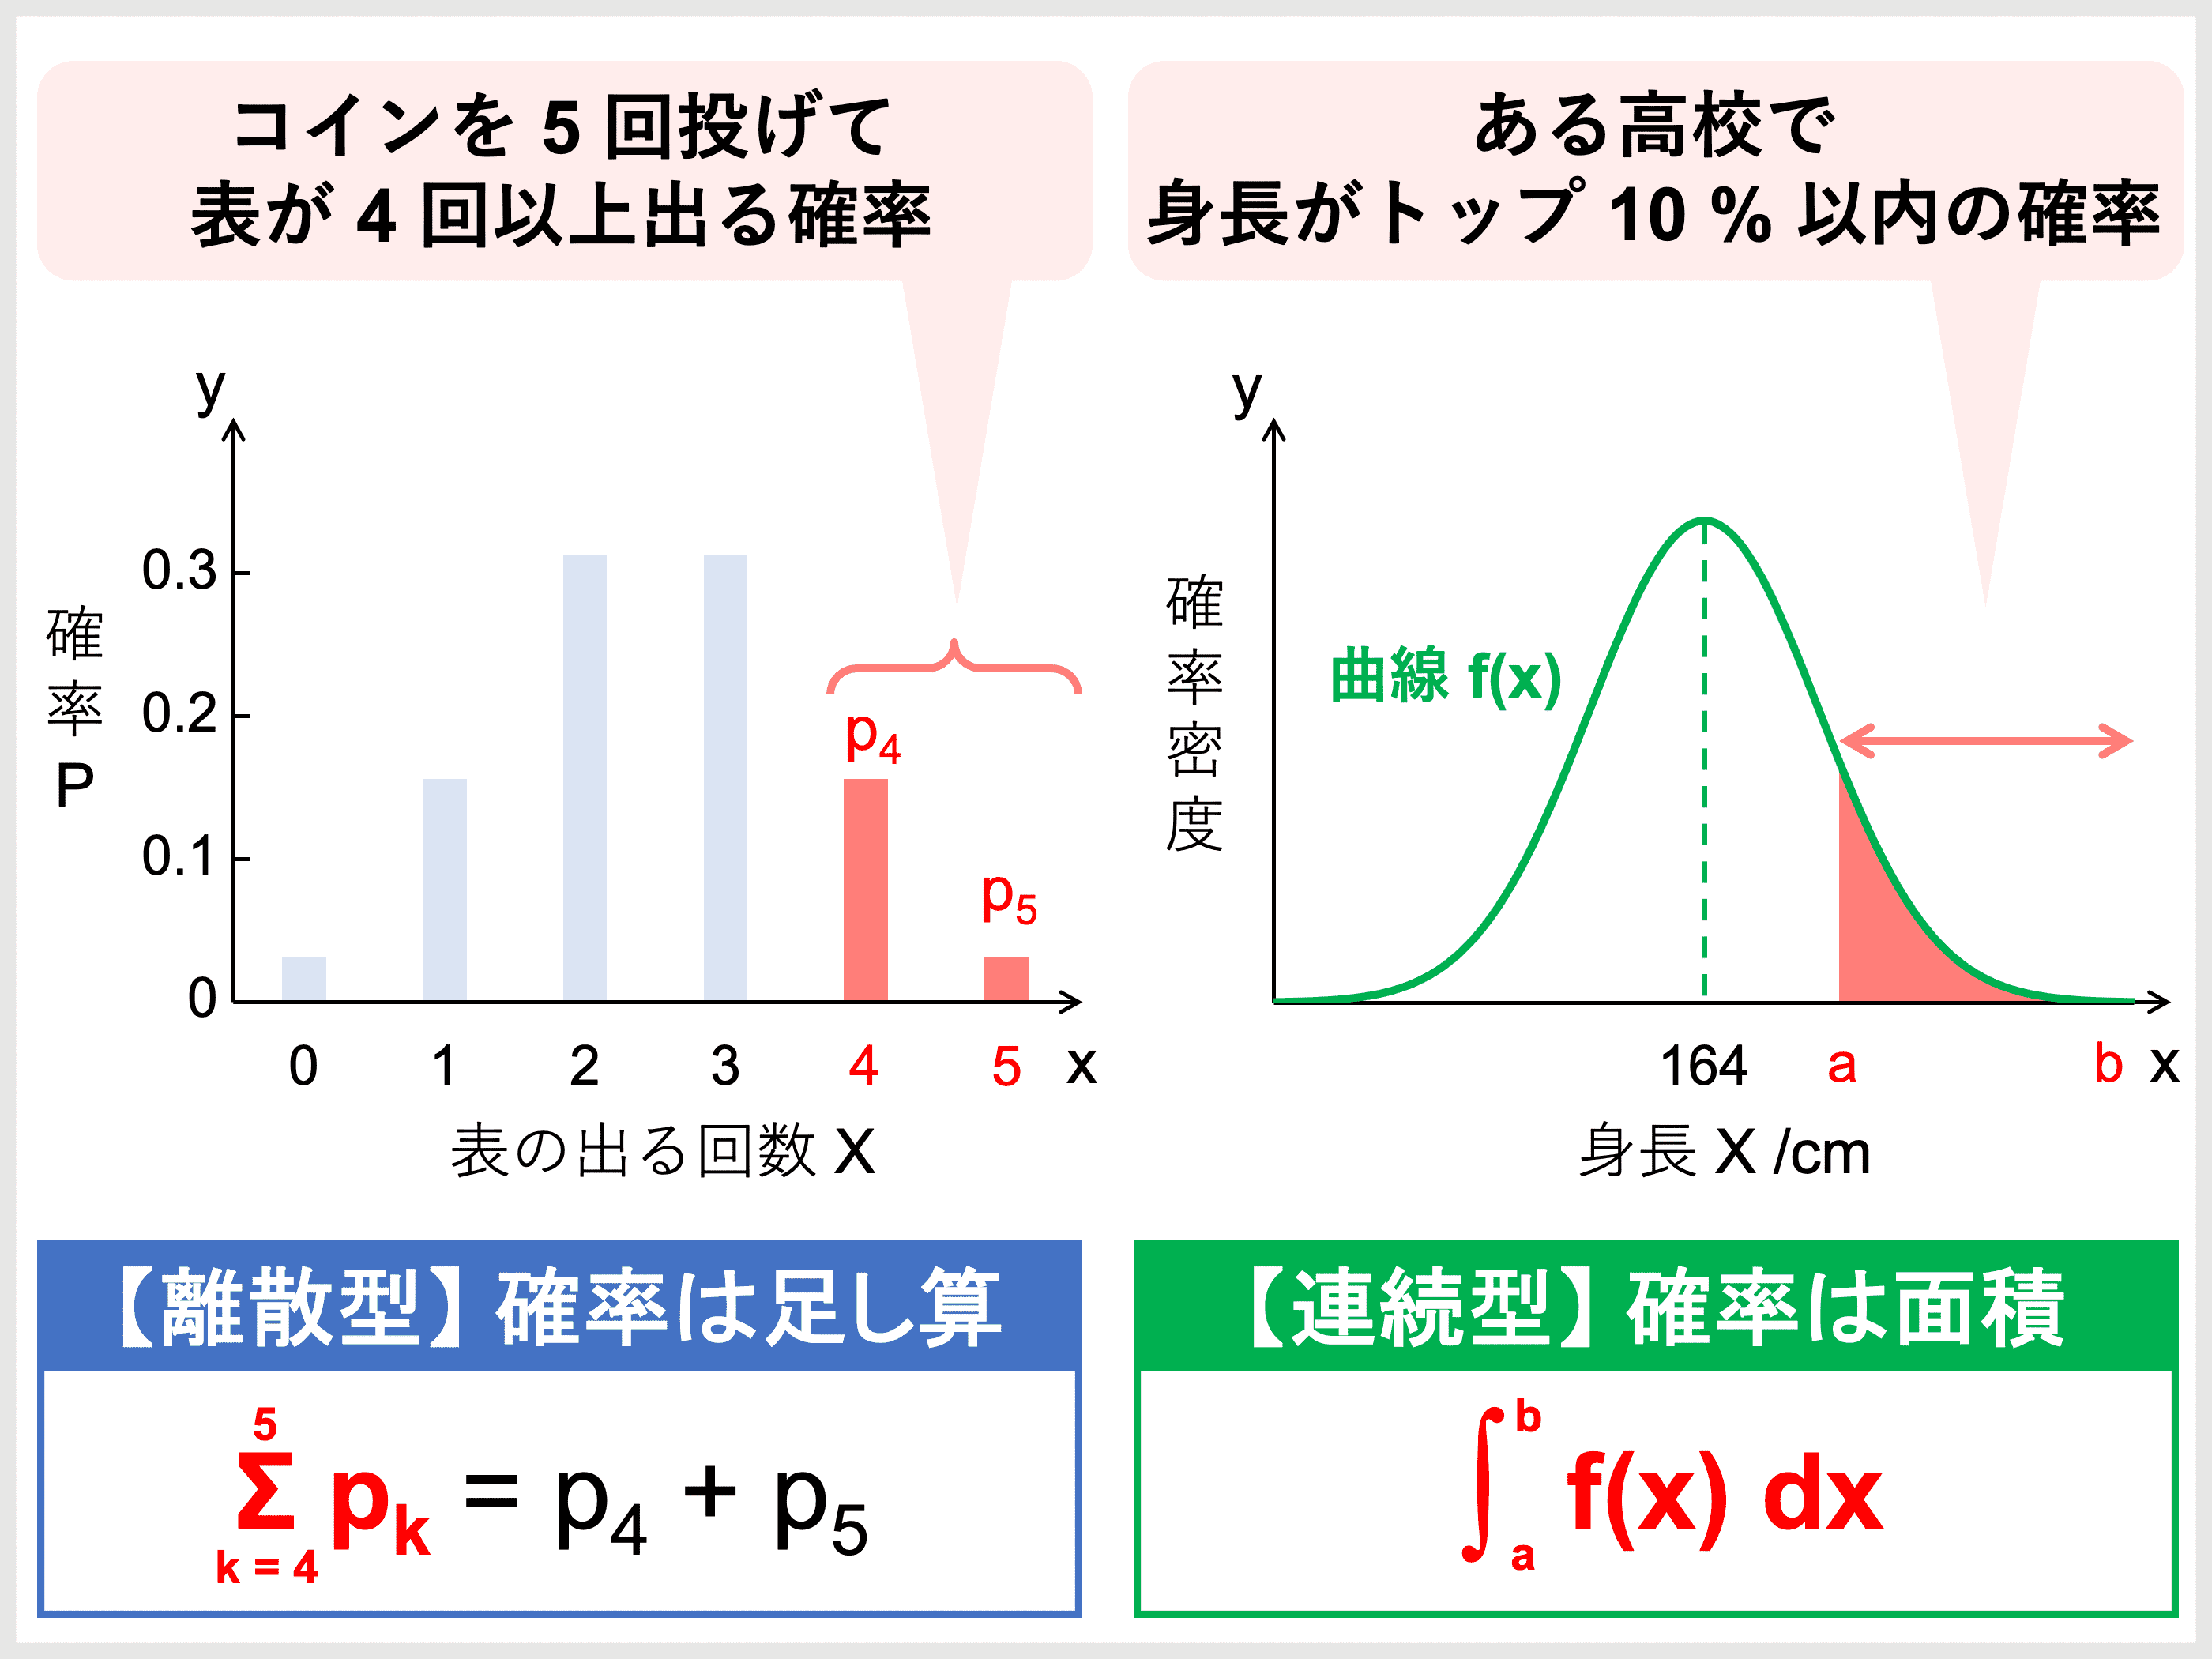
| 確率の求め方 | 該当する確率を単純に足し合わせる($\sum$) | 関数のグラフの下側面積を積分する($\int$) |
| 全確率の合計 | $\sum P(X = x) = 1$ | $\int_{-\infty}^{\infty} f(x) dx = 1$ |
| 代表的な分布 | 二項分布、ポアソン分布、幾何分布 | 正規分布、指数分布、t分布 |
連続型における最大の盲点:ピンポイントの確率は「ゼロ」になる
連続型確率変数を学ぶ際、誰もが驚く事実があります。それは、「身長がちょうど 170.00000...cm である確率」は計算上ゼロになるという点です。
連続的な数値の世界では、候補となる数値が無限に存在するため、1点ピンポイントの確率は極限として 0 になってしまいます。そのため、連続型では「169.5cm 以上 170.5cm 以下になる確率」というように区間(幅)を設定し、確率密度関数 $f(x)$ を積分した「面積」として確率を計算します。
また、ある値 $x$ 以下の値をとる確率をまとめた関数を累積分布関数 $F(x) = P(X \le x)$ と呼び、データのパーセンタイルや検定の棄却域を求める現場で欠かせないツールとして機能します。
【重要公式】確率分布・期待値・分散から「線形結合」まで完全整理
確率変数が定まると、その変数がどのような散らばりや中心を持つかを表す指標として「期待値」と「分散」を計算できるようになります。
1. 期待値(平均)と分散の定義
・期待値 $E[X]$(平均):確率変数 $X$ が長期的に平均してどれくらいの値をとるかを示す指標です。
離散型の場合:$E[X] = \sum x_i P(X = x_i)$
連続型の場合:$E[X] = \int_{-\infty}^{\infty} x f(x) dx$
・分散 $V[X]$:確率変数の値が期待値からどれくらい散らばっているかを示す指標です(標準偏差 $\sigma = \sqrt{V[X]}$)。
$$V[X] = E[(X - E[X])^2] = E[X^2] - (E[X])^2$$
2. 実務で多用される「線形結合の公式」
データを定数倍したり足し合わせたりする際、期待値と分散には美しい性質が存在します。定数 $a, b$ に対する以下の関係式は、試験・実務を問わず必須の公式です。
$$E[aX + b] = aE[X] + b$$
$$V[aX + b] = a^2 V[X]$$
期待値は定数の足し算や掛け算がそのまま反映されますが、分散は散らばり具合を表すため、$b$ を一律に足しても散らばり幅は変わらず、$a$ 倍された場合は $a^2$ 倍になります。
3. 確率変数の独立と2変数の合成
2つの確率変数 $X$ と $Y$ が互いに影響を与えない関係にあるとき、これらは「互いに独立(Independent)」であるといいます。
2つの確率変数の和については、独立性にかかわらず期待値の線形性が成り立ちます。
$$E[X + Y] = E[X] + E[Y]$$
一方、分散の足し算に関しては、$X$ と $Y$ が独立である場合に限り以下の単純な足し算が成立します。
$$V[X + Y] = V[X] + V[Y] \quad \text{($X, Y$ が独立のとき)}$$
※独立でない場合は、共分散(相関)を考慮した補正項が必要になります。
4. データを統一基準で測る「確率変数の標準化」
期待値 $\mu$、標準偏差 $\sigma$ を持つ確率変数 $X$ に対し、次の変換を行う操作を確率変数の標準化(Zスコア化)と呼びます。
$$Z = \frac{X - \mu}{\sigma}$$
この変換によって作られた新しい確率変数 $Z$ は、必ず期待値 0、分散 1 になります。異なるテストの点数を比較する「偏差値」や、機械学習モデルの前処理、正規分布を標準正規分布表に当てはめる検定作業において、標準化は中核的な役割を果たしています。
【実態検証】統計検定や高校数学でつまずく人の共通点と学習現場のリアル
学習指導要領の改訂に伴い、高校の「情報I」や「数学B・C」で統計分野が必修化され、ビジネス現場でもデータ分析やAI活用を背景に「統計検定」の受験者数が高水準を維持しています。しかし、学習コミュニティや受験者の手記を調査すると、多くの方が共通の壁に直面している実態が浮き彫りになります。
大手学習掲示板やSNS上で寄せられた初学者のリアルな声を分析すると、つまずきのパターンは主に以下の3点に集約されます。
- 「$E[X]$ や $V[X]$ の数式展開は暗記したが、確率変数が何を指しているのか感覚として掴めていない」
- 「離散型(二項分布など)から連続型(正規分布など)に移った瞬間、急に積分記号が出てきて思考停止した」
- 「独立性の仮定を意識せずに分散の加法性を適用し、試験で大量失点してしまった」
教育現場の指導者やデータサイエンス実務者の分析によると、統計学で挫折する人は「数式を抽象的な記号のまま処理しようとしている」傾向があります。逆にスムーズに習得する人は、常に「サイコロ」「コイン」「工場の検査ライン」「顧客の来店間隔」といった具体的な事象に頭の中で変換しながら数式を読み解いています。
【プロの結論】確実にマスターする人・慎重になるべき人の判断基準
統計学や確率変数の学習を進めるにあたり、学習者ごとの最適なアプローチは明確に分かれます。
【向いているアプローチ:直感を養いながら進める人】
・数式を見る前に「これはサイコロで言えばどの部分か?」と言語化する人
・まず二項分布(コイン投げ)の直感的なイメージを固めてから、試行回数を増やした極限としての正規分布へステップアップする人
・グラフの形状や面積のイメージを描いてから計算に移る人
【慎重になるべきアプローチ:公式の丸暗記に頼る人】
・大文字 $X$ と小文字 $x$ を区別せず、単なる未知数として解こうとする人
・確率密度関数の高さそのものを「確率」だと思い込んで計算を進めてしまう人
・独立性の条件を確認せずに公式を機械的に当てはめてしまう人
【確率変数とは】に関するよくある質問(FAQ)
Q1:中学校や高校の方程式で習った普通の変数($x$ や $y$)と確率変数は何が違うのですか?
A1:普通の方程式における変数は、「$2x + 4 = 10$」のように解けば 1 つ(または特定)の固定値に決まる未知数です。一方、確率変数は「振る前のサイコロの目」のように、試行するまでどの値になるか決まらず、それぞれの値に対して確率が割り振られているという根本的な違いがあります。
Q2:連続型確率変数で「特定の一点(例えば身長ちょうど170.000...cm)の確率が0」になるのはなぜですか?
A2:170cm と 171cm の間には、170.1、170.01、170.001... と無限に多くの数値が存在します。無数にある選択肢の中から完全に一致する1点を選ぶ確率は $\frac{1}{\infty} = 0$ と計算されるためです。そのため、連続型では「169.5cm 〜 170.5cm の幅」のように区間を設定し、確率密度関数の面積として確率を求めます。
Q3:統計検定2級や準1級を目指す場合、確率変数はどこまで深掘りして理解すべきですか?
A3:統計検定2級では、離散型(二項分布、ポアソン分布)と連続型(正規分布)の期待値・分散の計算、確率変数の線形結合、標準化の手続きを確実に計算できるレベルが必須です。準1級以上を目指す場合は、同時確率分布、条件付き期待値、確率母関数や積率母関数(モーメント母関数)を用いた証明レベルまで押さえておく必要があります。
まとめ:確率変数の本質を押さえてデータサイエンスの土台を固めよう
確率変数は、一見すると難解な数式記号の羅列に見えますが、その正体は「偶然に左右される現実世界の事象を、数学の土俵で扱うための架け橋」です。
「確率変数 $X$ と実現値 $x$ の役割分担」「離散型と連続型の違い」「期待値・分散の線形結合ルール」という基本構造をしっかり押さえておけば、その後に続く二項分布や正規分布、仮説検定、機械学習アルゴリズムの理解度は格段に向上します。
まずはサイコロやコイントスといった直感的なイメージを手がかりに、数式の意味を1行ずつ噛み砕きながら学習を進めてみてください。確固たる土台が身につくことで、データ分析の視界が驚くほどクリアに開けていくはずです。 (出典: 確率 変数 と は(Yahoo!ニュース))
毎日更新されるトレンド情報を分析・発信中。役立つ裏技やおすすめ情報を分かりやすく紹介します。
