主成分分析とは?基本原理と機械学習PCAの活用法をわかりやすく解説
ビッグデータや高次元データを扱う現場において、「変数が多すぎて全体の傾向がつかめない」「グラフで可視化できず意思決定が進まない」という課題に直面するケースは少なくありません。そうしたデータ肥大化の壁を突破する統計的アプローチとして、ビジネスや研究開発の第一線で重用されているのが主成分分析(PCA: Principal Component Analysis)です。
本記事では、難解な線形代数の数式を極力排し、主成分分析のコアとなるメカニズムや因子分析との決定的な違い、実務における活用メリットをわかりやすく紐解きます。PythonやR言語、エクセルを用いた実装のポイントから、固有値・寄与率の正確な読み解き方まで、2026年現在の実務標準に即して徹底解説します。
📌 【この記事の重要ポイントまとめ】
- 要点1:主成分分析は多次元データの情報を損なわずに2〜3次元へと要約する「次元削減」の代表的手法であり、可視化や機械学習の前処理に不可欠。
- 要点2:観測変数から合成変数を作る「主成分分析」と、背後にある潜在因子を探る「因子分析」は目的も計算ロジックも明確に異なる。
- 要点3:固有値1.0以上・累積寄与率80%前後を目安に主成分を選定し、主成分得点と散布図を組み合わせることで現場の深い洞察が得られる。
【超入門】主成分分析(PCA)とは?多次元データを要約する基本原理
主成分分析(PCA)とは、多数の相関がある変数を統合し、元のデータの情報をできる限り保持したまま、より少数の互いに無相関な合成変数(=主成分)へと変換する多変量解析手法です。英語表記の「Principal Component Analysis」の頭文字を取ってPCAとも呼ばれます。
例えば、商品の購買データに「価格への納得感」「デザイン性」「耐久性」「ブランド力」「機能の豊富さ」など10項目以上の評価指標がある場合、人間の脳が10次元の空間を直接把握することは不可能です。そこで主成分分析を活用し、10個の指標を「総合的なコストパフォーマンス(第1主成分)」と「情緒的・デザイン的価値(第2主成分)」といった2〜3つの軸へ次元削減します。これにより、平面の散布図上にデータをプロットし、全体像を一目で把握できるようになります。
直感的なイメージとしてよく用いられるのが「3次元物体の影絵」のメタファーです。複雑な形状をした立体に光を当てて壁に影を落とす際、物体の特徴が最もハッキリと現れる角度を探す作業こそが主成分分析のアルゴリズムに相当します。統計学的には、データの「分散(散らばり)」が最大になる方向を見つけ出し、それを新たな座標軸として再定義しているのです。
機械学習の領域において、PCAは単なる可視化ツールにとどまりません。多変量データをそのままモデルに投入すると、変数間の強い相関によって生じる「多重共線性(マルチコ)」や、計算量が爆発する「次元の呪い」に直面します。主成分分析によって情報量を保ちながら変数を圧縮することは、予測モデルの精度向上と学習コスト削減を両立させる極めて強力なアプローチとなります。

主成分分析と因子分析の決定的な違い|目的・アプローチの比較検証
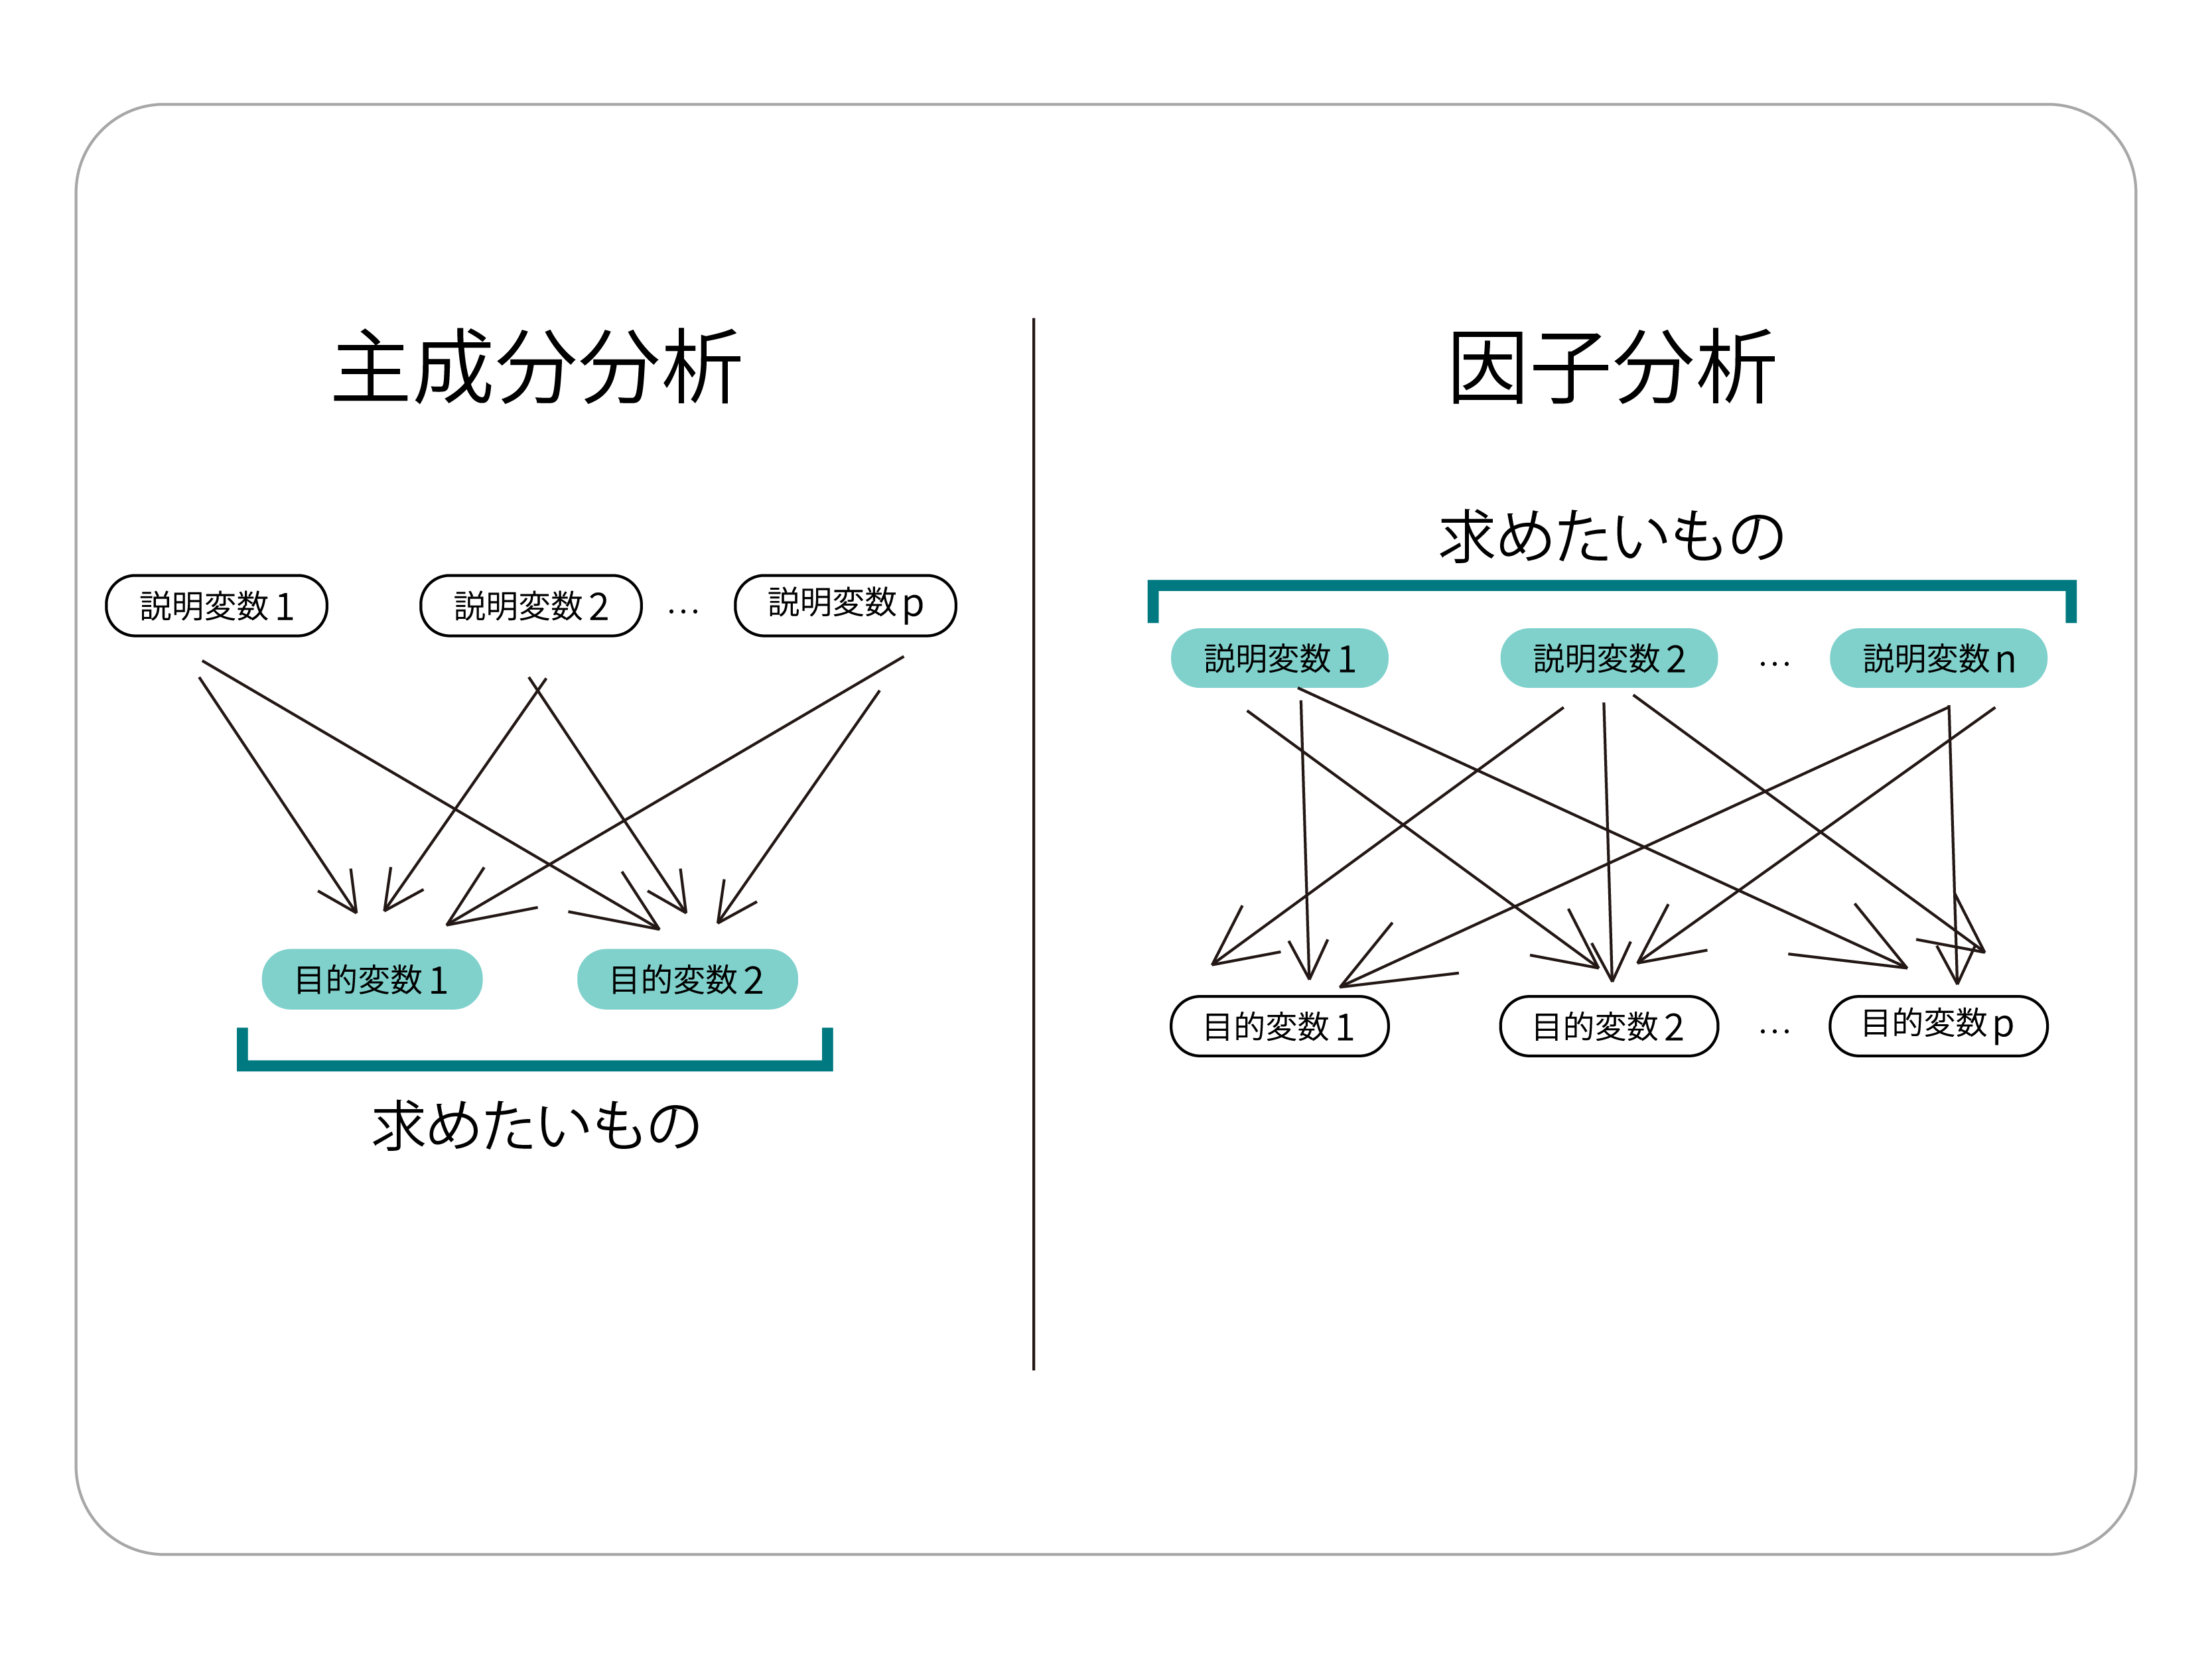
データ分析の初学者が最もつまずきやすいのが、主成分分析と「因子分析」の混同です。どちらも変数をまとめる手法であるため同一視されがちですが、その背景にある数理的発想と適用目的は根本的に異なります。
主成分分析の目的は「観測データの要約・情報の圧縮」です。測定された複数の変数から計算によって合成変数(主成分)を作り出します。一方、因子分析の目的は「観測データの背後にある潜在的な原因の探求」です。「アンケートの回答結果の裏には、目に見えないどんな心理的要因が働いているのか」を推測するために用いられます。
| 比較項目 | 主成分分析(PCA) | 因子分析(Factor Analysis) | 実務における選択基準 |
|---|---|---|---|
| 主目的 | データの次元削減・情報要約 | 潜在構造の抽出・因果仮説の探索 | 要約ならPCA、構造解明なら因子分析 |
| データの流れ | 観測変数 → 主成分(外向きの集約) | 潜在因子 → 観測変数(内因の影響) | モデル設計の因果の向きで判断 |
| 軸の回転 | 直交のみ(分散最大化の順に固定) | 直交回転・斜交回転(解釈性重視) | 回転させて解釈しやすくしたい場合は因子分析 |
| 代表的な用途 | 機械学習の前処理、総合指標の作成 | 心理テストの開発、顧客満足度構造分析 | 工学・予測はPCA、心理・社会調査は因子分析 |
| 計算の一意性 | 数学的に解が1つに定まる | 初期値や回転法により結果が変動し得る | 再現性と自動化を重視するパイプラインはPCA推奨 |
実務で失敗しないための指標解釈|固有値・寄与率・主成分得点・散布図の見方
主成分分析を実行すると、様々な統計量が出力されます。実務で意思決定に直結する重要指標は「固有値」「寄与率」「主成分負荷量」「主成分得点」の4点です。これらを正しく解釈できないと、誤ったデータ判断を招く恐れがあります。
まず、どの主成分までを採用すべきかを判断する基準が固有値と寄与率です。固有値は各主成分が保持している「情報量の大きさ(分散)」を示します。一般的には、固有値が1.0以上の主成分を採用する「カイザー・ガットマン基準」が広く普及しています。これは「元の変数1個分の情報量以上を持っている主成分のみを残す」という論理に基づいています。
一方、寄与率はその主成分が元データの情報全体の何割を説明できているかを示す割合です。第1主成分から順に足し合わせた累積寄与率を確認し、実務では一般的に70%〜80%以上に達するまでの主成分を採用するのが標準的な目安とされています。
主成分の性質を読み解く際は、各変数と主成分の相関係数である主成分負荷量(Factor Loading)を確認します。例えば、第1主成分に対して国語や英語の負荷量が大きくプラスであれば、その軸を「文系能力」と命名することができます。そして、各サンプル(ユーザーや商品)がその新しい軸上でどの位置にいるかを数値化したものが主成分得点です。
横軸に第1主成分得点、縦軸に第2主成分得点を取って描画した散布図(バイプロット)を観察することで、「競合製品群の中で自社製品がどのポジションに孤立しているか」「離脱傾向の高いユーザー層がどの象限に集中しているか」を視覚的に特定できます。

【実態検証】データ分析現場のリアルな声と主要ツール(Python・R・Excel)の使い分け
主成分分析を実行する環境は、分析の目的やデータの規模によって適正が分かれます。データサイエンスの現場コミュニティや実務担当者の知見をもとに、主要3ツールの特性と選び方を整理しました。
Pythonは、機械学習システムへの組み込みや大規模データ処理においてデファクトスタンダードです。scikit-learnライブラリのPCAクラスを使用すれば、わずか数行のコードで標準化から次元削減までをパイプライン化できます。画像処理や自然言語処理の分散表現など、数千〜数万次元に及ぶデータを扱う現場ではPython一択といえる状況です。
R言語は、統計解析の学術的厳密さやレポート作成の美しさを求める現場で根強い支持を得ています。標準機能のprcomp()関数に加え、factoextraパッケージを組み合わせることで、固有値のスクリープロットや主成分負荷量と個体プロットを重ね合わせた高品質なバイプロットを瞬時に可視化できます。
一方、ビジネス現場で最も身近なエクセルでも、分析ツールアドインや共分散・固有値計算の行列関数(MMULTやINDEXなど)を駆使すれば主成分分析を実行できます。しかし、データ行数が数千件を超えると動作が著しく重くなる点や、変数の標準化を手作業で行う際の人為的ミスのリスクが指摘されています。実務での小規模な予備分析や、社内プレゼン用の簡易的な可視化に用途を絞るのが安全です。
一般に知られていない盲点と誤解|PCA万能論に潜む3つの罠
主成分分析は非常に便利な手法ですが、その前提条件やアルゴリズムの特性を理解せずに盲信すると、重大な見落としを引き起こします。現場で頻発する3つの落とし穴に注意が必要です。
1つ目の罠は、「標準化(スケーリング)の未実施」です。主成分分析は分散が最大となる方向を探すアルゴリズムであるため、単位が異なる変数をそのまま投入すると、数値の絶対値が大きい変数(例:年収数百万円)に主成分の軸が引っ張られ、数値の小さい変数(例:満足度1〜5点)の情報が無視されてしまいます。異なる単位が混在する場合は、必ず平均0・分散1に変換する標準化処理(相関行列に基づく分析)を徹底しなければなりません。
2つ目の罠は、「非線形な関係性を捉えられない」という数学的制約です。通常の主成分分析は「線形結合」を前提としているため、データがU字型や円状に分布しているような非線形構造を持つ場合、重要な情報を見落とす危険があります。こうしたデータに対しては、カーネルPCA(Kernel PCA)やt-SNE、UMAPといった非線形次元削減手法の適用を検討する必要があります。
3つ目の罠は、「合成された主成分の解釈性の喪失」です。元の10変数を2つの主成分に圧縮した結果、計算上は累積寄与率85%を達成したとしても、「第1主成分がビジネス的に何を意味しているのか」が誰にも言語化できないケースが存在します。機械学習の特徴量として扱うだけであれば問題ありませんが、経営陣への報告やマーケティング施策に落とし込む際は、現場感覚と照らし合わせた無理のない命名と解釈が求められます。
【プロの結論】主成分分析を導入すべきケースと避けるべき判断基準
認知工学や情報処理の観点から見ると、主成分分析の本質は「人間の認知限界(3次元まで)と機械の計算効率を橋渡しする情報の抽象化」にあります。導入の成否を分ける判断基準は以下の通りです。
【主成分分析を強く推奨するケース】
- 数十項目に及ぶアンケートデータから、顧客を分類するための2軸マップ(ポジショニングマップ)を作成したい場合
- 回帰分析やクラスタリングを行う前段階で、変数間の強い多重共線性を解消したい場合
- センサーデータや画像データからノイズを除去し、主要なシグナルのみを高速に抽出したい場合
【主成分分析の適用を慎重に避けるべきケース】
- 「どの変数が目的変数にどれだけ直接的な影響を与えたか」という個別の因果関係を厳密に証明・説明したい場合
- 変数同士に相関関係がほとんど存在せず、互いに独立している場合(PCAを実行しても次元削減の効果が得られない)
- 外れ値(極端な異常値)のクリーニングが未完了のデータ(外れ値によって主成分の方向が歪むため)
【主成分分析とは】に関するよくある質問(FAQ)
Q1:主成分分析を行う前に、変数の標準化は必ず必要ですか?
A1:変数の単位が異なる場合(例:身長cmと体重kg、売上金額と客数など)は、標準化が必須です。標準化を行わないと、数値の単位が大きい変数の影響力ばかりが過大評価されてしまいます。すべての変数が「5段階評価のアンケート」のように同一尺度で測定されている場合に限り、標準化を行わない分散共分散行列を用いた分析が選択されることもあります。
Q2:主成分は何個まで残せばよいですか?
A2:一般的には2つの基準を組み合わせます。1つ目は「固有値が1.0以上」の主成分を採用するカイザー・ガットマン基準、2つ目は「累積寄与率が70%〜80%」に達するまでを採用する基準です。また、グラフ化して視覚的に確認したい場合は、解釈のしやすさを優先して第2主成分(2次元)または第3主成分(3次元)までに絞り込むケースが多く見られます。
Q3:主成分分析はビッグデータやディープラーニングの時代でも使われていますか?
A3:現在でも極めて重要です。深層学習の前処理としてデータの次元を圧縮して計算負荷を下げる用途や、オートエンコーダーとの比較検証、さらには高次元の埋め込みベクトル(Embedding)を可視化してモデルの振る舞いを分析する用途など、現代のAIエンジニアリングにおいても基礎技術として活用され続けています。
まとめ:今後の動向と失敗しないための判断基準
主成分分析(PCA)は、氾濫する多次元データから本質的な情報を抽出し、人間の直感的な理解と機械の効率的な処理を可能にする不朽の分析基盤です。
実務で成果を上げるためには、単にライブラリを実行するだけでなく、標準化の要否、固有値や累積寄与率に裏付けられた主成分の選択、そしてビジネス文脈に沿った主成分の命名・解釈を丁寧に行う姿勢が欠かせません。まずは手元の多変量データに対して相関行列を確認し、次元削減によってどのような新たなインサイトが浮かび上がるかを検証してみることを推奨します。 (出典: 主 成分 分析 と は(Yahoo!ニュース))
テクノロジーやライフスタイル領域を中心に執筆活動を行っています。趣味は写真撮影と旅行です。
