読めない漢字を一発検索!2026年最新の読み方特定術とAI活用法
ビジネス文書の確認や公的書類の作成、あるいは街中の看板や小説の読書中に、読み方の見当すらつかない漢字に直面して手が止まった経験は誰しも一度はあるはずです。キーボードやスマートフォンでの入力が当たり前となった現在、読むことはできても書けない、あるいは形は視認できるものの読みが分からずタイピングすらできないという「検索の壁」が生じています。
かつては分厚い漢和辞典をめくり、見出しの部首や画数を数えながら何分もかけて調べていた作業は、デジタル技術とAI認識の進化によって劇的に変化しました。手書き入力の認識精度向上やスマートフォンのカメラによる画像解析の普及に伴い、読めない漢字を特定するアプローチはかつてないスピードと正確性を獲得しています。現在利用できる主要な検索手法と、現場で役立つ効率的な特定テクニックを検証していきます。
📌 【この記事の重要ポイントまとめ】
- 要点1:読み方が分からない漢字は、ブラウザ対応の手書き漢字検索やスマートフォンの画像で漢字読み取り機能を活用することで、筆順の誤りに関わらず数秒で特定可能。
- 要点2:漢字辞典オンラインなど約29,000字(JIS第1・第2水準網羅)を収録する専門データベースでは、部首検索や総画数検索、漢字構成パーツ検索を組み合わせることで、旧字体や難読人名も漏れなく照合できる。
- 要点3:日常業務や学習の効率化には、単一のツールに頼るのではなく、文字の状態(印刷物、崩し字、デジタル画面)に応じた最適な検索ルートを選択するリテラシーが不可欠。
読めない漢字はどう調べる?現場で役立つ検索裏ワザと最新テクニック
画面や紙面にある未知の文字を前にした際、最も確実かつスピーディーに解決するためのアプローチは、状況に応じた入力手段の使い分けにあります。従来の辞書検索でつまずきがちだった「部首の特定ミス」や「総画数の数え間違い」を回避する手法が確立されています。
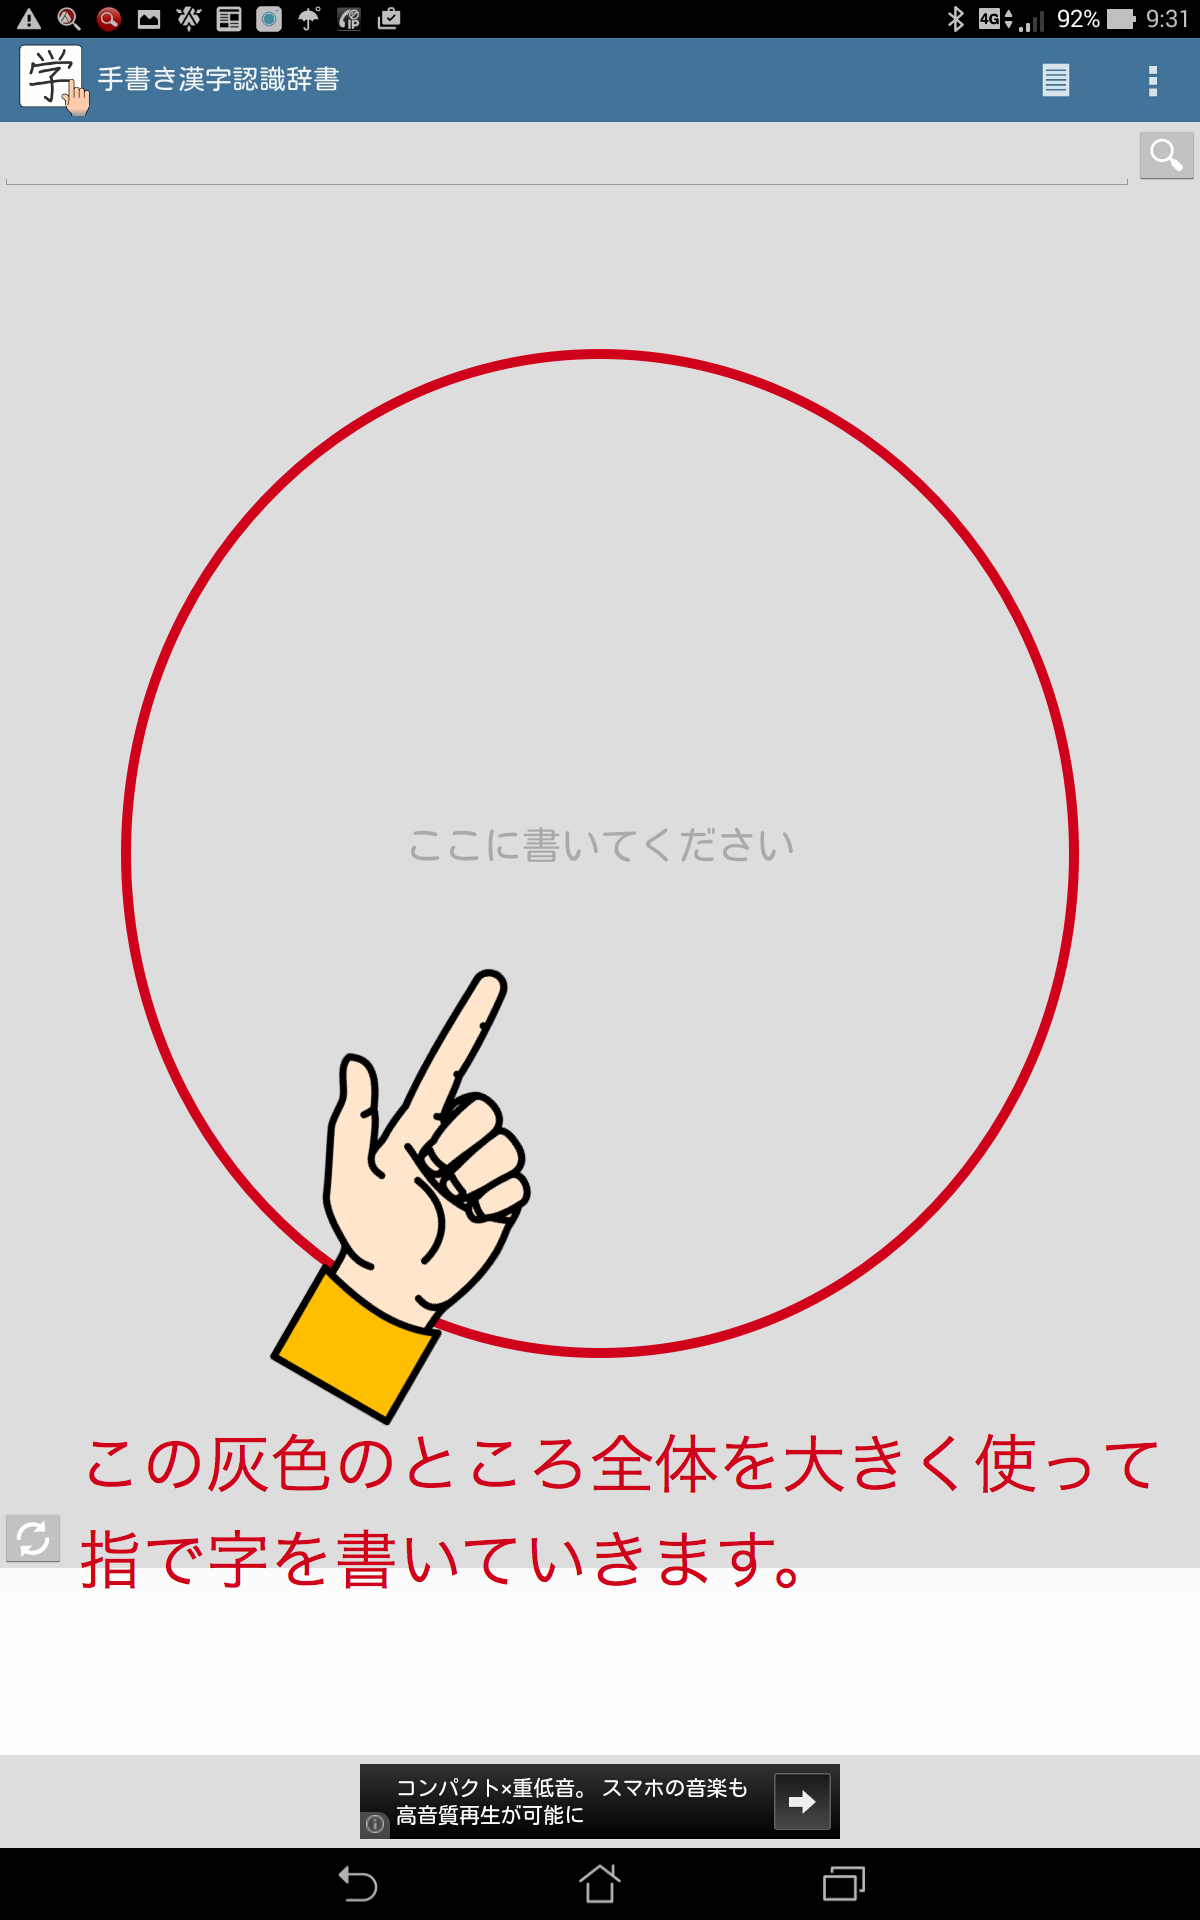
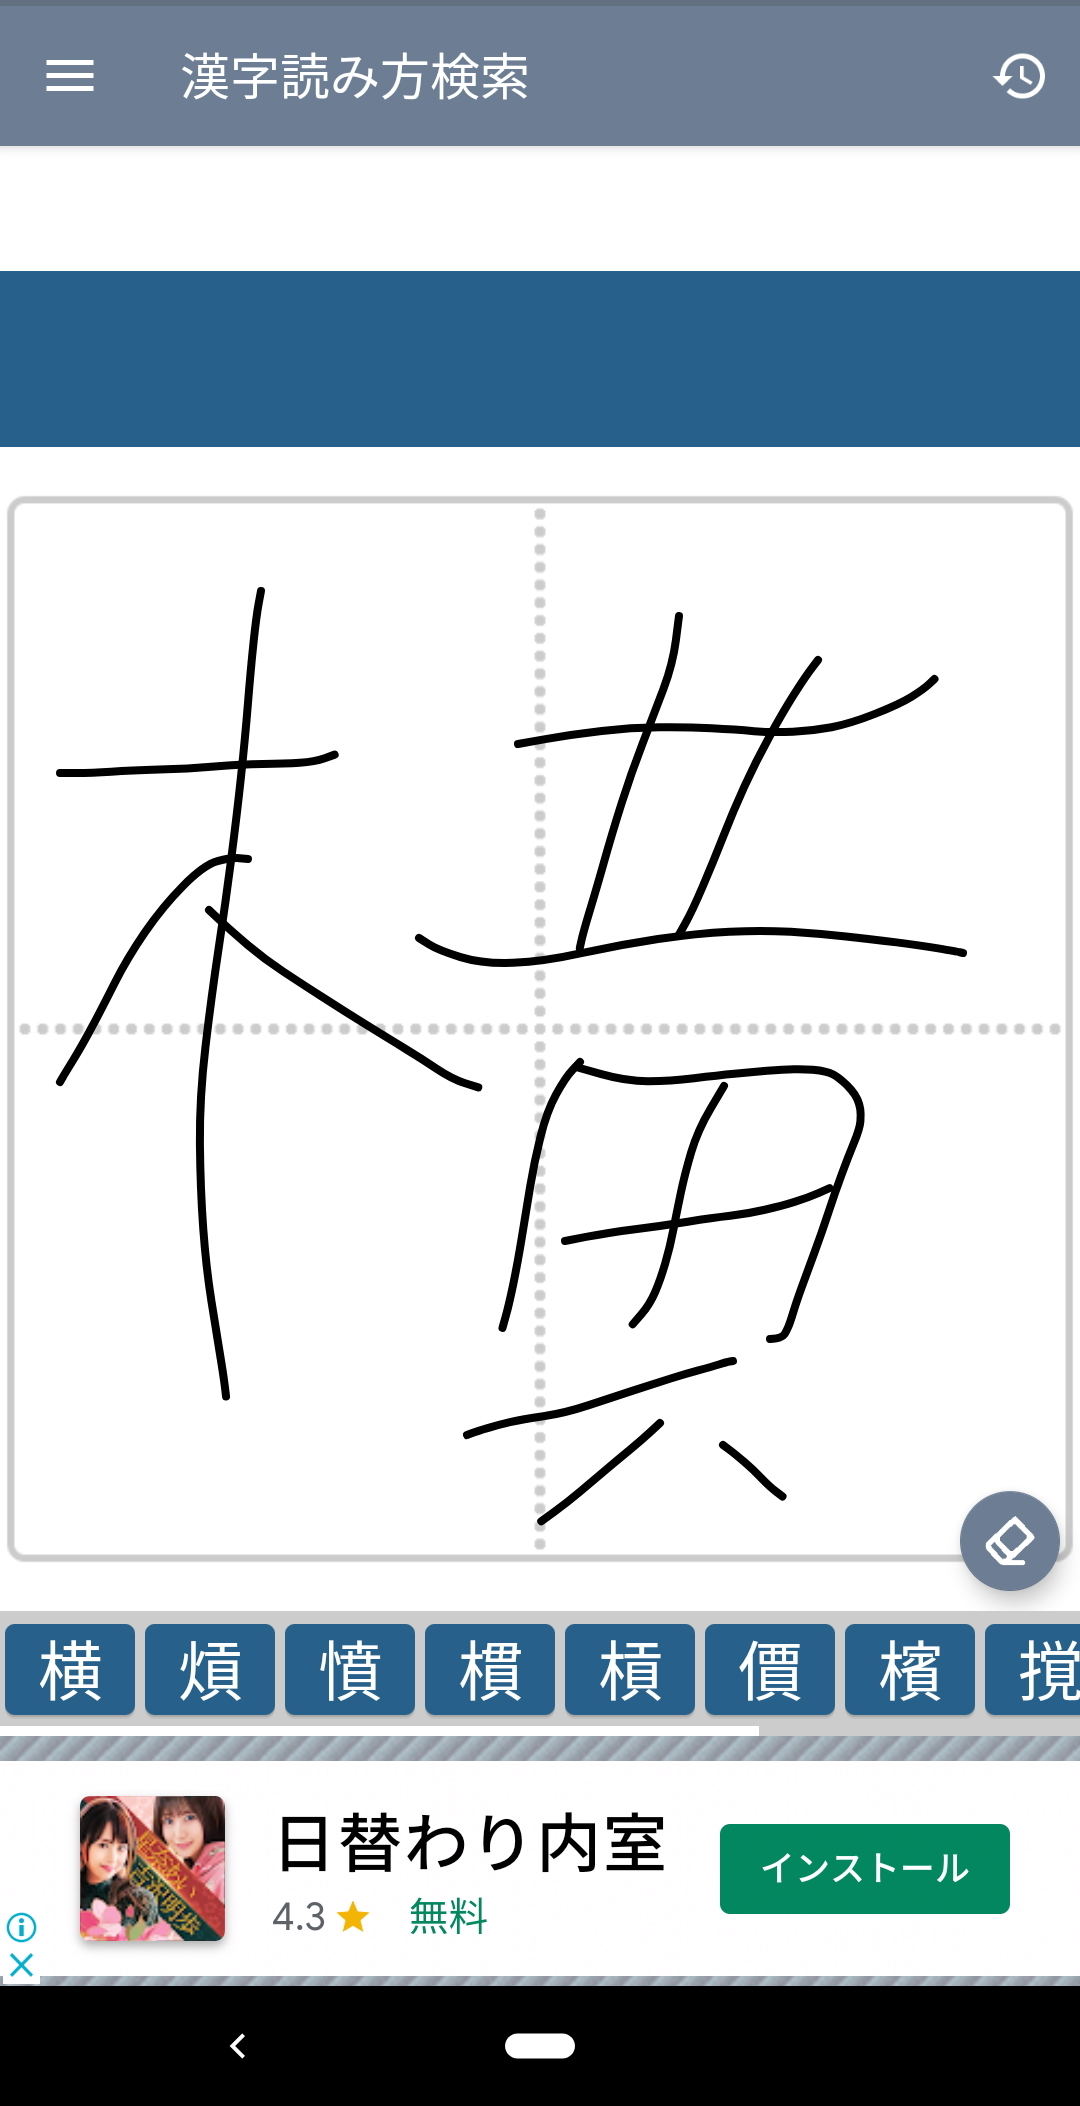
現在主流となっているのは、Webブラウザ上で完結する無料漢字検索ツールの活用です。専用のスマホ手書き入力アプリを別途インストールせずとも、主要な漢字検索プラットフォームでは画面上に指先やマウスで文字をなぞるだけで、機械学習アルゴリズムが候補を瞬時に提示します。特にモジナビや各種手書き入力エンジンでは、正しい書き順から外れていたり、画数が多少前後していたりしても、形状の類似度から目的の漢字を高精度で選出する仕組みが整っています。
さらに、スマートフォンの標準カメラやOCR(光学文字認識)エンジンを用いた画像で漢字読み取りは、長文の資料や看板などの特定において圧倒的な作業短縮をもたらします。文字の周囲を指でトリミングしてスキャンにかけるだけで、文字コード情報が抽出され、そのままWeb検索や辞書機能へと連動します。
一方で、手書き入力でうまく認識されない崩し字や画数の多い文字に対しては、文字を構成要素に分解して調べる漢字構成パーツ検索が威力を発揮します。たとえば「鬱」という難字であれば、「木」「缶」「木」「冖」「鬯」「彡」といった分かる部分の組み合わせから絞り込むことができ、正確な読みへ確実に到達可能です。
【徹底比較】無料漢字検索ツールの精度と主要サービスの実力検証
漢字検索を支援するWebサービスや検索エンジンの機能は、それぞれ得意とする領域が明確に分かれています。用途や入力環境に応じて適切なサービスを選択することが、作業効率を左右する鍵となります。
| 項目 | 詳細・数値データ | 一般的な基準・相場 | 編集部の見解・評価 |
|---|---|---|---|
| 漢字辞典オンライン | 収録数:約29,000字 JIS第1・第2水準完全網羅 | 常用漢字(2,136字)〜JIS水準 | 四字熟語や故事成語、書き順動画まで網羅し、学術・実務双方で標準辞書として極めて信頼性が高い。 |
| AI手書き認識ツール(モジナビ等) | 認識速度:0.1〜0.3秒 筆順不同での推論対応 | 正確な筆順入力が必要な旧エンジン | 書き順の乱れやラフな筆記でも高精度に一致漢字を抽出可能。直感的な検索に最適。 |
| OS標準カメラOCR(iOS/Android) | 文字認識率:活字印刷で98%以上 クリップボード直結 | 外部OCRアプリの起動が必要 | 紙資料や看板からの読み取りにおいて最速。ただし手書き文字や装飾フォントでは誤認識のリスクあり。 |
| 構成パーツ・属性検索エンジン | 部首・総画数・部分文字列 3系統の絞り込み機能 | 単一属性(画数のみ等)での検索 | 字形の一部しか判読できない劣化印刷物や難読漢字の特定において、論理的消去法による確実な同定が可能。 |
公的データや各種辞書プラットフォームの仕様を照合すると、一般的な文章で遭遇する99%以上の文字は、JIS第1・第2水準をカバーするWeb辞書で解決できます。印刷されたテキストならOS標準の画像認識、画面上の文字ならパーツ検索や手書き入力といった形で、対象物のフォーマットに応じてツールを使い分けることが肝要です。
人名・地名から難読漢字まで|用途別の最適ルートと調べ方の盲点
一般的な語彙だけでなく、名刺交換や歴史資料の読解で直面しやすいのが「人名」や「異体字」の読み方です。人名漢字の読み方は、戸籍法や命名規則の制約を受けつつも、訓読み・音読みにとどまらない独自の「名乗り(なのり)」が存在するため、通常の辞書引きでは正解に辿り着けないケースが多々あります。
たとえば、「翔」を「と」と読ませたり、「希」を「のぞみ」や「き」以外の響きで当てたりするケースです。人名特有の読みを特定する場合は、単漢字の検索にとどまらず、苗字・名前の専門データベースや人名読み対応の索引を活用するのが鉄則です。
また、古い契約書や登記簿謄本、家系図などを扱う際に避けて通れないのが旧字体・異体字の調べ方です。「齊藤」「齋藤」「斎藤」「斉藤」のようなバリエーションや、「髙(はしご高)」「﨑(たつさき)」といった環境依存文字は、通常のキーボード入力候補に出現しにくい特徴があります。
こうした特殊文字を同定するには、親字(新字体)から引ける異体字一覧を備えた漢字辞典オンラインなどの総合プラットフォームが威力を発揮します。親字の常用漢字の読み方と意味を確認した上で、その系統に連なる異体字コードを照合することで、法務・不動産実務における記載ミスを完全に防ぐことが可能です。
文芸作品や古典に見られる難解な語彙については、難読漢字一覧などのカテゴリ別インデックスを参照することで、植物名(「躑躅=つつじ」「百日紅=さるすべり」)や魚介類(「鮃=ひらめ」「鰈=かれい」)といった体系的な知識と結びつけながら効率的に調べることができます。

【実態検証】利用者の生の声とデジタル検索現場で見えたリアル
実際のオフィスワークや日常生活において、漢字検索を行うユーザーはどのような課題に直面しているのでしょうか。大手知恵袋サービスやSNS上のコミュニティ、事務現場へのヒアリングから見えてくるのは、「便利になった反面、入力時のちょっとした勘違いで泥沼にはまる」という実態です。
「部首だと思い込んでいた部分が実は単なる飾りだった」「総画数を1画多く数えてしまい、一覧に出てこない」といった声は後を絶ちません。代表的な例として、「初」の部首を「示偏(しめすへん=礻・4画)」と思い込み、「衣偏(ころもへん=衤・5画)」で見つけられないケースや、「巨」の画数を4画ではなく5画で計算してしまうケースが挙げられます。
また、近年の画像認識機能(OCR)に関しても、現場からは以下のようなリアルな検証結果が報告されています。
「縦書きの明朝体や教科書体はほぼ100%読み取れるが、デザイン性の高い筆文字フォントや、居酒屋の看板のような崩し文字になると、まったく別の類似漢字に誤変換されることがある」(デザイン会社勤務・30代)
「手書き入力アプリを使う際、慌てて殴り書きするとAIが『木』と『禾』、『日』と『曰』を取り違えてしまい、意図しない候補ばかりが並んで余計に時間がかかった」(行政書士補助者・40代)
技術の精度が向上した現代においても、ツール側の認識アルゴリズムの特性(幾何学的な直線の配置やアスペクト比)を理解していないと、かえって検索に手間取るという現象が浮き彫りになっています。
一般に知られていない盲点とネットの誤解
インターネット上の情報や検索補助機能に関して、広く信じられているものの実際には誤りである「思い込み」がいくつか存在します。正確な情報収集を行うために、以下の3つの盲点を把握しておく必要があります。
第一に、「正しい筆順で書かないと手書き検索はヒットしない」という古い認識です。十数年前のガラケーや初期の電子辞書では、ストローク数と書き順の順序データを厳密に照合していたため、筆順を間違えると候補が出ませんでした。しかし、現在の機械学習ベースの手書き認識エンジンは、書き順よりも「最終的な線画の幾何学的配置とトポロジー」を重視して推論を行っています。書き順が分からない難字であっても、見た目通りに枠内へ描くだけで正確に抽出されます。
第二に、「漢和辞典の部首は直感で分かる」という誤解です。たとえば「勝」の部首は「月(つきへん・にくづき)」ではなく「力(ちから)」であり、「執」の部首は「幸」ではなく「土」です。このように、日常的な見た目と体系上の部首が一致しない漢字は無数に存在します。部首検索でヒットしない場合は、部首に固執せず総画数検索や手書き認識へ即座に切り替えるのが鉄則です。
第三に、「パソコンで表示できる漢字=すべて公的書類に使える」という誤認です。Unicodeの拡張によりPCやスマホで表示可能な文字数は数万字に及びますが、人名用漢字や常用漢字として戸籍・住民票に登録できる文字には法的な制限(戸籍法・戸籍法施行規則)が存在します。画面上で検索・表示できたからといって、そのまま正式書類に使用可能とは限らない点に留意が必要です。
デジタル認知心理学から見る漢字リテラシーの変容
読めない漢字を瞬時に検索できる環境は、人間の記憶構造や認知プロセスにも構造的な変化をもたらしています。認知心理学の領域では、外部記憶装置や検索エンジンに記憶保持を依存する現象を「トランザクティブ・メモリ(組織的・外部的記憶)」や「Google効果」と呼びます。
かつては「漢字を覚えること=読みと書き順を脳内に定着させること」でしたが、情報過多な環境下では「漢字の形状からインデックス(索引)を作成し、適切なツールから即座に出力する能力」へとリテラシーの定義がシフトしています。これは脳の認知的負荷(コグニティブ・ロード)を軽減し、より高度な文脈理解や文章構成に思考リソースを配分するための合理的な適応と解釈できます。
しかし一方で、検索した結果を「その場限りの消費」にしてしまうと、語彙の体系的ネットワークが形成されず、文章の読解速度そのものが低下するリスクも指摘されています。単に読み方をコピー&ペーストするだけでなく、語源や部首の持つ意味構造(例:「さんずい」は水に関する意味、「ごんべん」は言葉に関する意味)を意識的に関連付けることが、長期的な言語能力の維持につながります。
【プロの結論】検索手法の向き・不向きと失敗しない使い分け基準
膨大な漢字データと各種検索ツールを前にして、日常業務や学習で最もタイムパフォーマンスを高めるための判断基準を整理しました。状況に応じて以下のルートを適用してください。
【画像検索・OCRが最も適しているケース】
・書籍、印刷物、ポスターなど実物が目の前にある場合
・長文の中に複数の読めない漢字が連続して含まれている場合
・注意点:装飾フォントや掠れた印影は誤認識しやすいため、読み取った後の文字を目視確認することが必須。
【手書き漢字検索が最も適しているケース】
・PCやタブレットの画面上にあり、テキストコピーが禁止されている画像データ内の文字
・部首や画数がまったく見当もつかない複雑な単一文字
・注意点:線同士の交差や「はね・はらい」を極力明確に描くことで推論精度が最大化する。
【部首・パーツ・総画数検索が適しているケース】
・手書き認識でうまく候補が出ない難読漢字や異体字
・古文書や石碑など、一部が欠損して全体の形状が崩れている文字
・注意点:「にんべん」「きへん」など確実に判別できるパーツを軸にして消去法で絞り込む。
【漢字 読み方 検索】に関するよくある質問(FAQ)
Q1:スマートフォンでアプリをインストールせずに手書きで漢字を検索するにはどうすればよいですか?
A1:Webブラウザ(SafariやGoogle Chromeなど)を開き、漢字辞典オンラインや「モジナビ」などの無料漢字検索サイトにアクセスするだけで利用できます。スマートフォンの画面上に表示される入力枠に指で文字を書画すれば、AIが候補漢字を提示してくれます。また、Googleのトップページでも検索設定から「手書き入力」を有効化することで、ブラウザ上で直接手書き検索が可能です。
Q2:古い戸籍や登記簿で見かける「崩し字」や「旧字体」の読み方を調べるコツはありますか?
A2:まずは判読できる部分を分解し、漢字構成パーツ検索で絞り込むのが確実です。また、新字体(現在の標準的な漢字)の見当がつく場合は、総合漢字サイトで新字体の詳細ページを開き、関連付けられている「異体字・旧字体一覧」を確認すると一発で同定できます。どうしても判別が難しい崩し字の場合は、国立公文書館や大学の研究機関が公開している崩し字特化型のAI認識アプリを活用するのも有効な手段です。
Q3:部首の名前や読み方が分からない場合、どうやって調べればよいですか?
A3:部首の名称が不明なときは、全体の画数を数えて総画数検索を利用するか、画面上での手書き入力検索に切り替えるのが最も手戻りがありません。また、主要な辞書サイトには「部首一覧(字形別インデックス)」が用意されており、「木」「氵」「亻」といった形状の見た目から直感的に部首を選択して逆引きすることも可能です。
まとめ:漢字検索の進化とこれからの実践的アプローチ
読めない漢字を調べる行為は、かつての「手作業による辞書探索」から「マルチモーダルAIとデータベースの即時連携」へと完全に進化を遂げました。手書き認識、高精度OCR、パーツ検索といったツールを状況に応じてシームレスに使い分けることで、情報探索にかかる時間は劇的に短縮されます。
大切なのは、単に読み方を特定して終わるのではなく、その漢字が持つ意味や語源、関連する語彙へと視野を広げることです。進化したデジタル検索ツールを自身の知的能力を拡張するパートナーとして使いこなし、日々の業務や知的活動の生産性を高めていきましょう。 (出典: 漢字 読み方 検索(Yahoo!ニュース))
SEOライティングとマーケティング戦略の専門家。分かりやすい解説記事で定評があります。
